关于 Robots.txt 生成器
Robots.txt生成器把你选好的规则拼成一份有效的robots.txt文件,整个过程在浏览器里完成,不用逐行手敲指令。ToolsPivot这一版从各平台当前自带的默认文件起步,覆盖现行的搜索引擎爬虫和AI爬虫,替你写好带*和$的通配符规则,边写边检查那些会让网站从搜索结果里消失的错误。生成之后,可以把任意网址放进去测试,也可以配合站点地图生成器把Sitemap地址一起写进文件。
如何使用ToolsPivot生成robots.txt文件
- 在第1步“起始模板”里选一个起点:全部允许、WordPress、WooCommerce、Joomla、Drupal、Magento、Shopify、测试站或全部屏蔽。网站已经有文件的话,用“加载现有文件”粘贴原文,或者在“检查线上文件”里输入域名,直接取回线上版本。
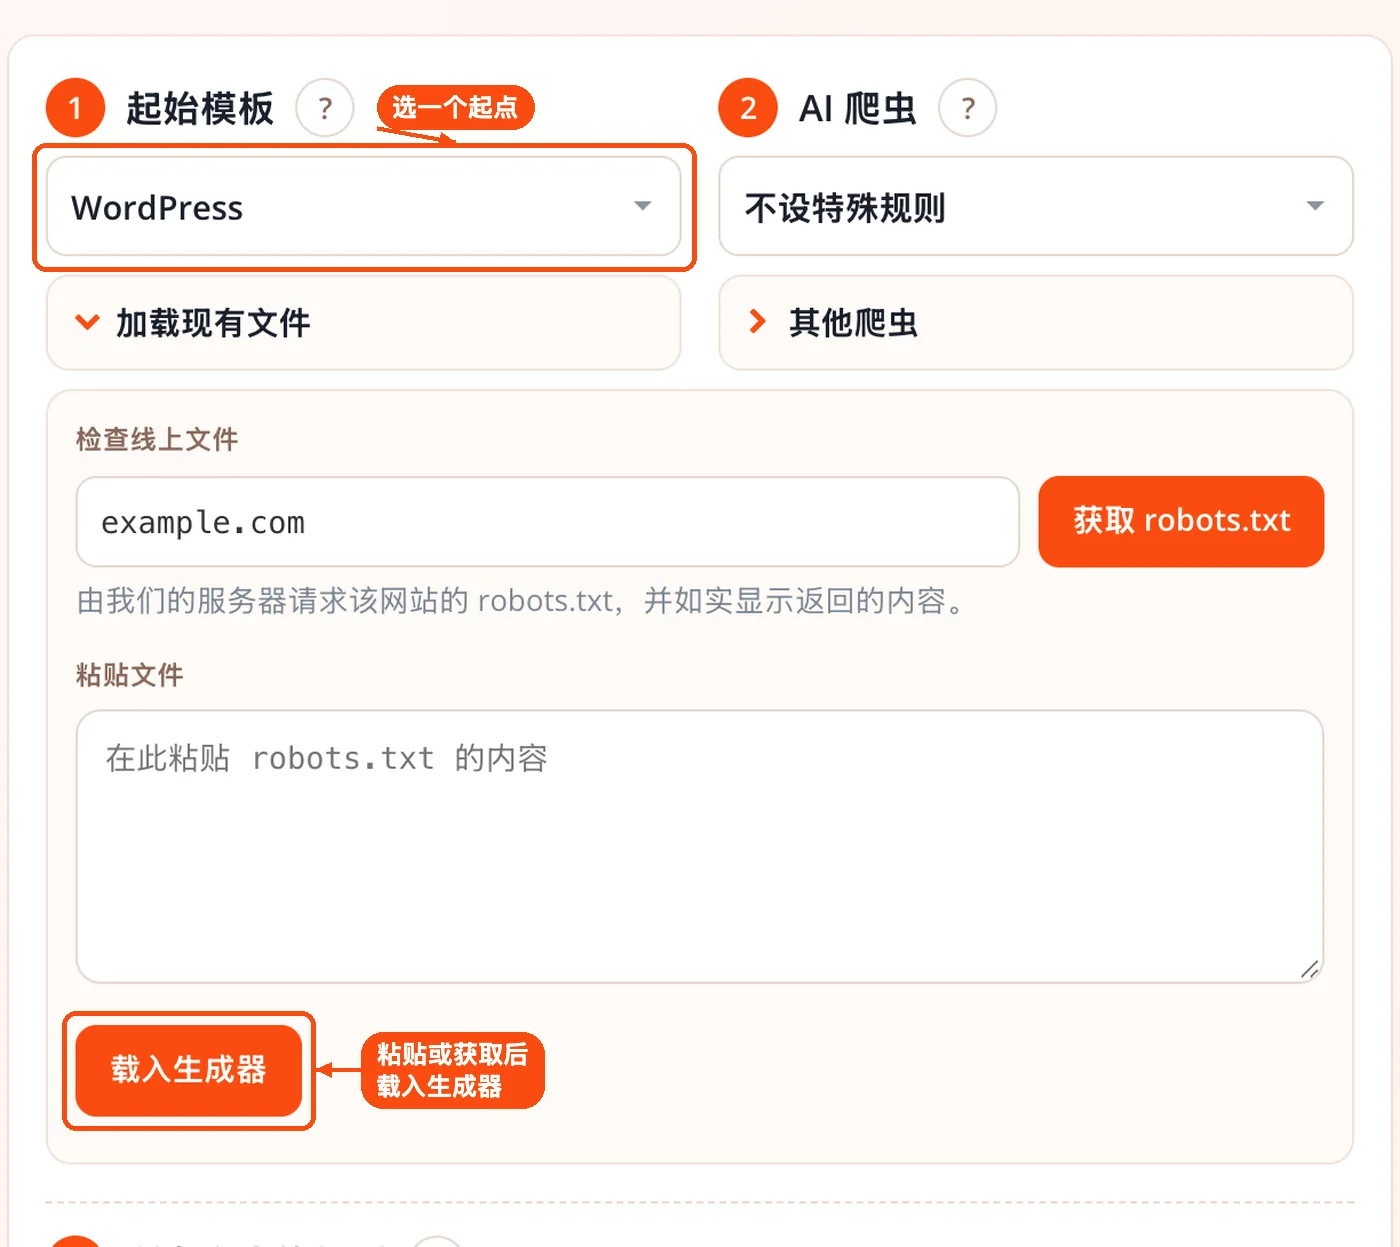
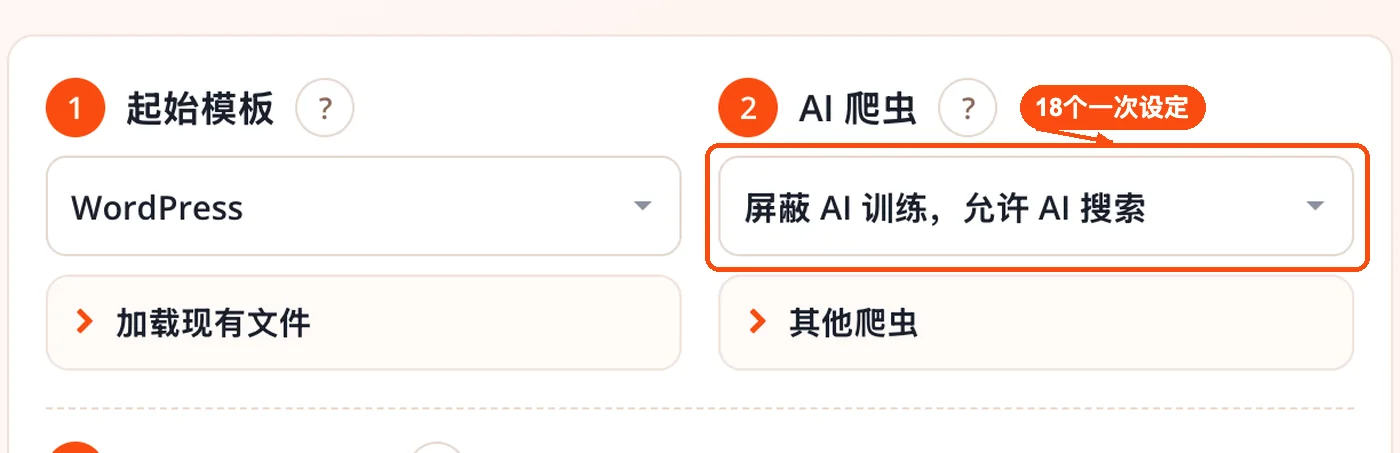
- 在第2步“AI 爬虫”里做一次选择,同时设定18个AI爬虫:不做特殊处理、屏蔽AI训练但允许AI搜索、屏蔽全部AI爬虫,或者逐个设置。
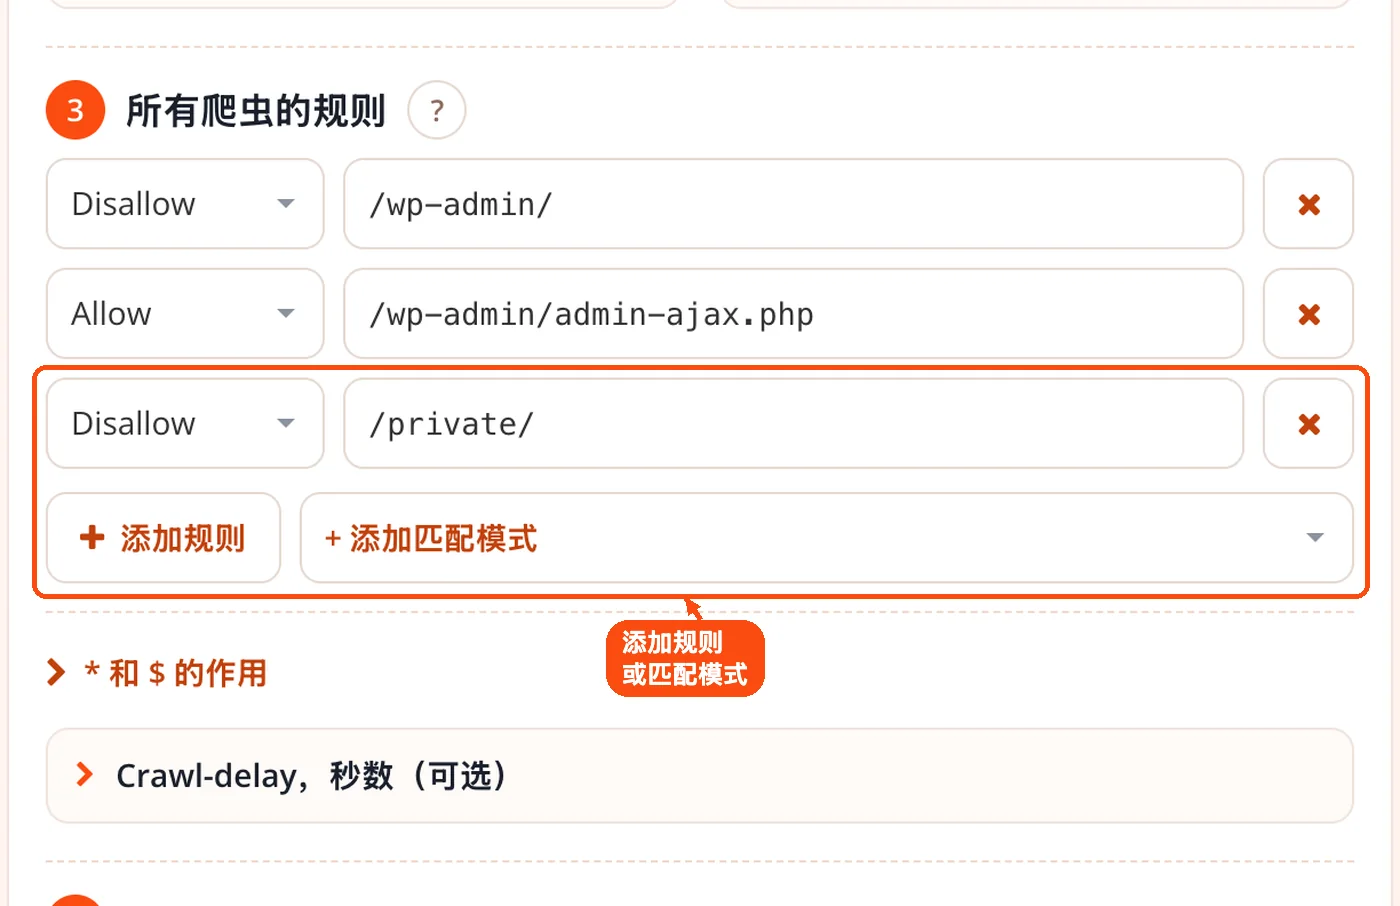
- 在“所有爬虫的规则”里点“添加规则”,逐行写Allow或Disallow,也可以直接套用现成的通配符写法。要给某个爬虫单独设规则,就用“按名称添加其他爬虫”,再点“添加专属规则”。
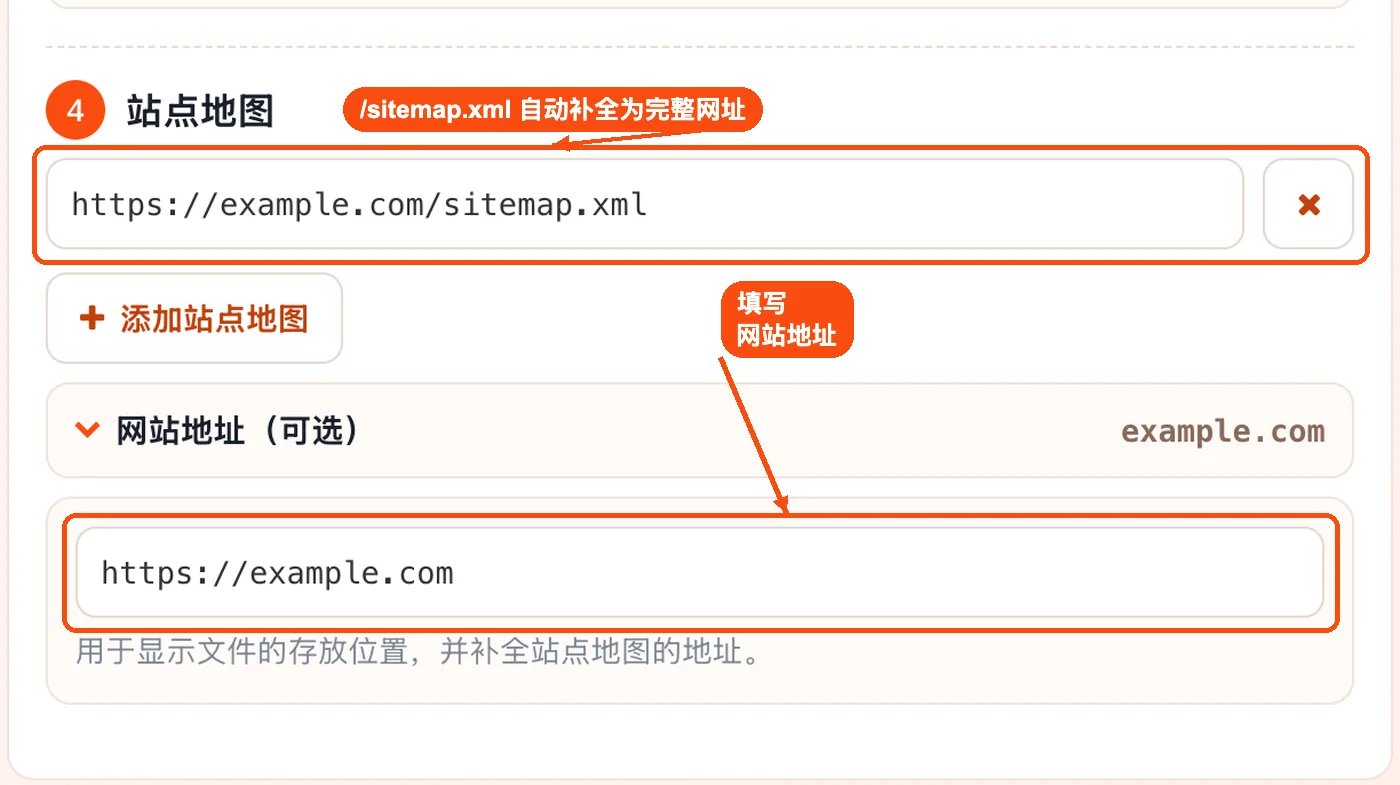
- 在“站点地图”里点“添加站点地图”,可以加不止一条。只填/sitemap.xml这样的路径也行,生成器会补全成完整网址。
- 右侧“你的文件”随输入实时更新。先看检查清单和白话摘要,再用“测试地址”试几个关键网址,最后点“复制”或“下载”,也可以复制一个能还原整套设置的链接,下次接着改。
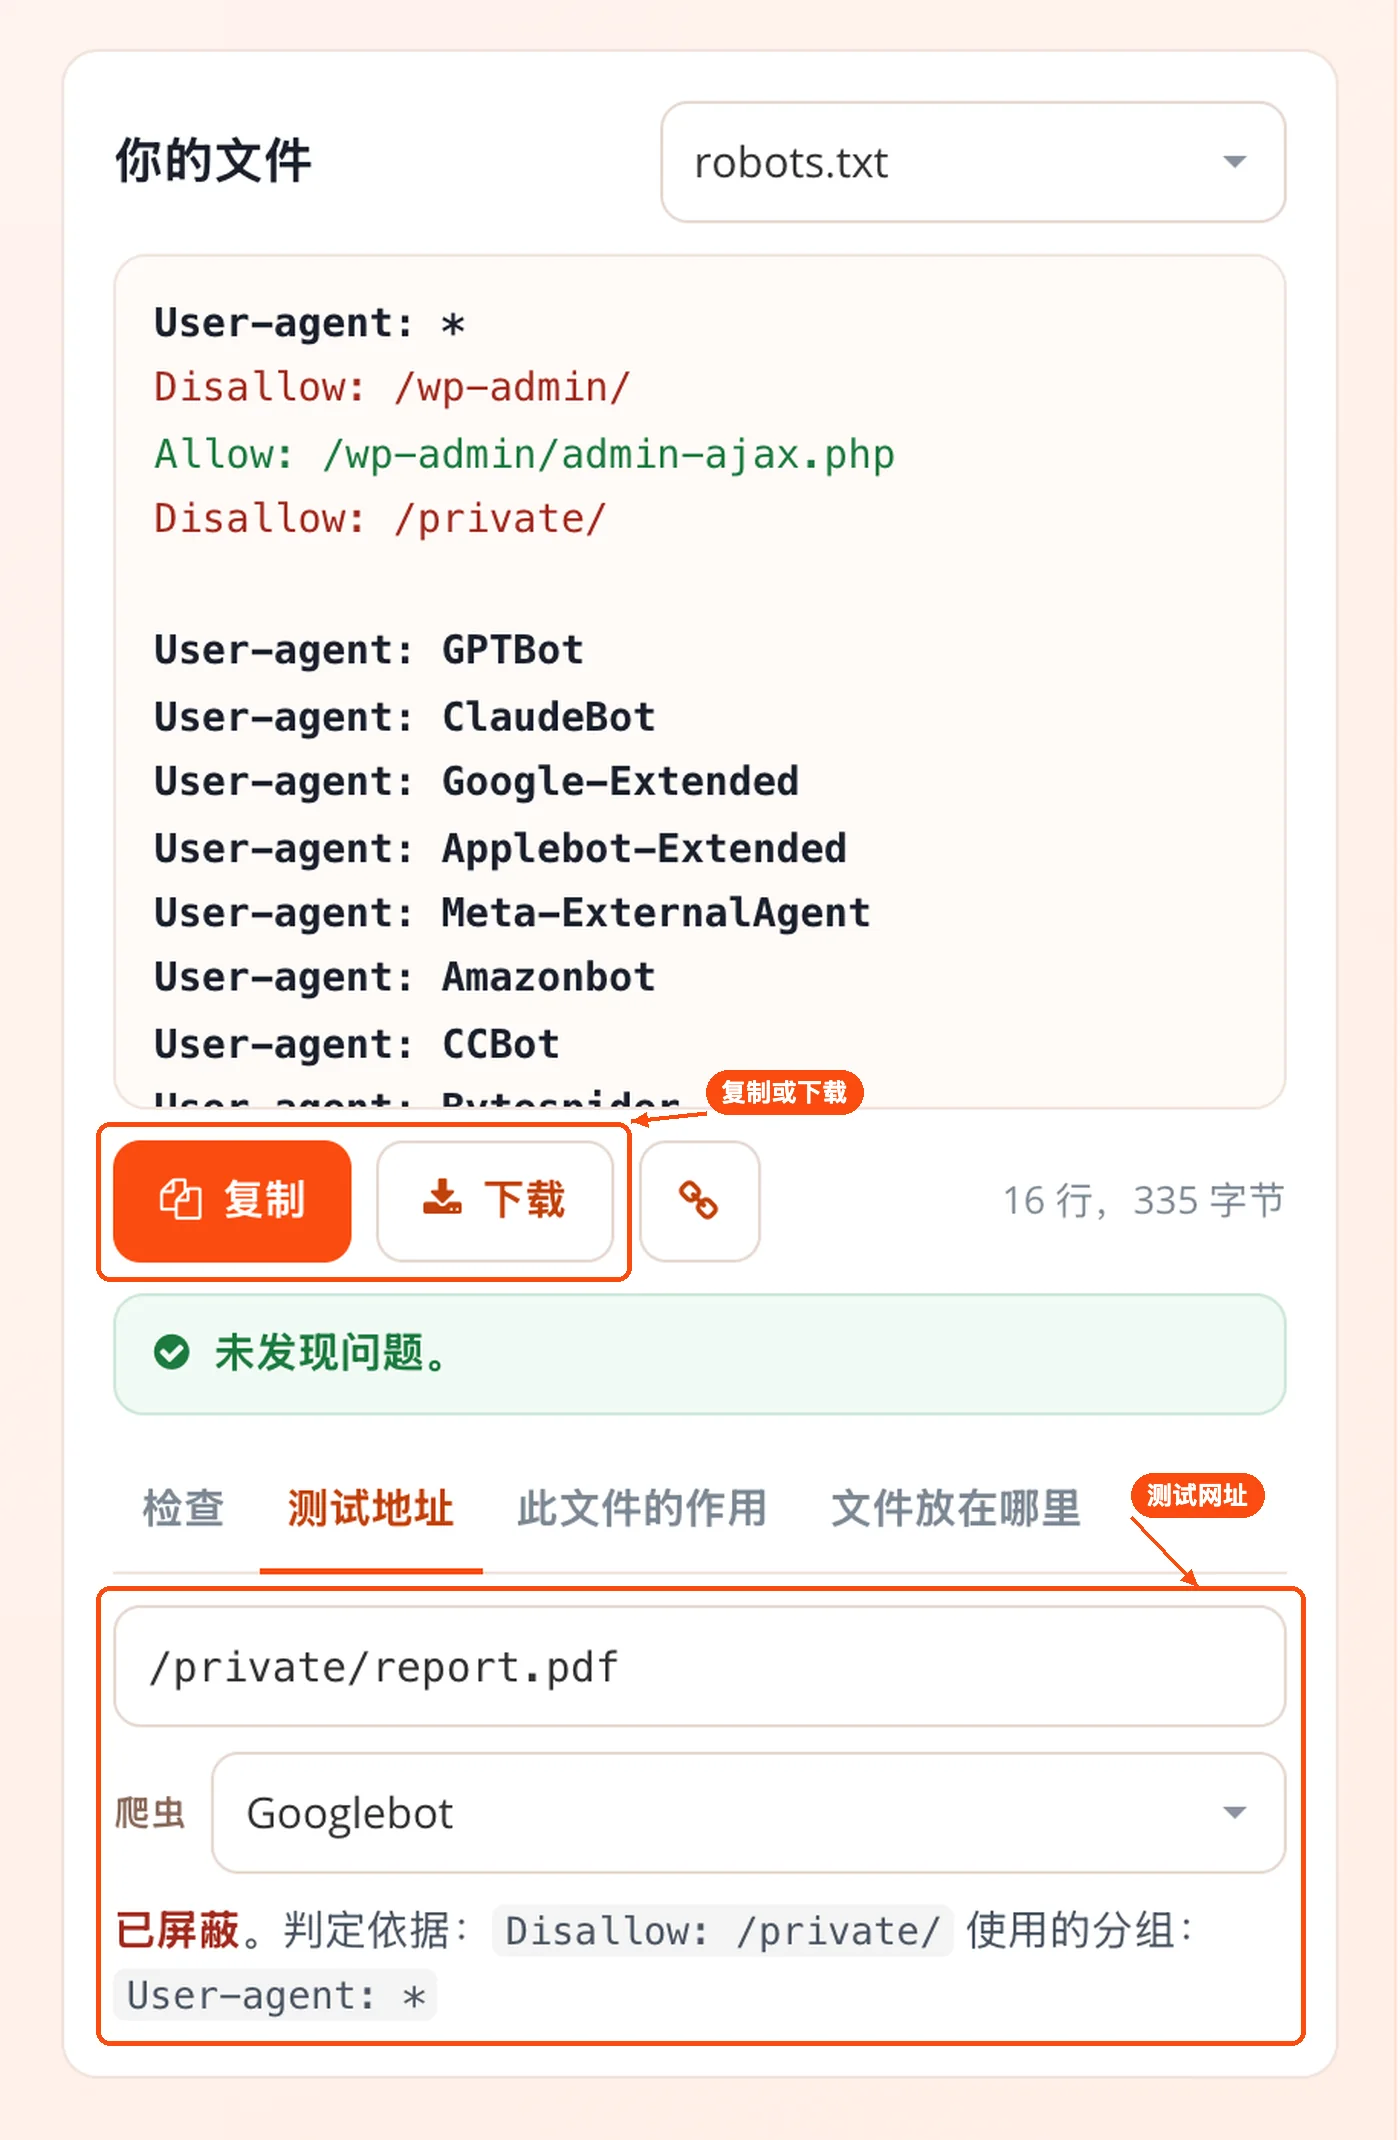
除了取回线上文件,解析、写文件、校验和路径匹配都由浏览器里的JavaScript完成,这些代码是ToolsPivot自己写的,匹配器不依赖正则表达式。服务器只在你检查线上文件时参与:它只接受域名,固定请求该域名下的/robots.txt,拒绝内网地址,也不需要API密钥。
九种起始模板怎么选
起始模板决定文件的底子。平台模板取的是平台本身当前的默认内容:WordPress核心自己输出的规则、WooCommerce 10.3在此基础上加的几行、Joomla 5.4和6.1随安装包附带的文件、Drupal 11的文件,以及Magento 2.3+的默认文件。
对WordPress站来说,这一点影响最大。WordPress核心现在只屏蔽/wp-admin/,同时放行/wp-admin/admin-ajax.php。可网上不少中文教程给的“完整版”模板,仍然写着Disallow: /wp-includes/和Disallow: /wp-content/,等于把系统脚本、主题和插件目录一起挡住。jQuery就在/wp-includes/目录下,把这类模板载入后用测试地址一查,会看到Google抓不到jQuery,渲染页面时缺了脚本。
Shopify店铺选Shopify模板后,可以把输出切换成“Shopify (robots.txt.liquid)”:生成的模板保留Shopify默认规则,再追加你自己的规则。测试站模板用于还没上线的预发布环境,全部屏蔽模板则是整站Disallow: /。这两个模板最容易在上线后忘记撤掉,下文的检查项会专门盯住这一条。
AI爬虫:屏蔽训练,不等于退出AI搜索
第二步把18个AI爬虫按用途分成三类:训练类、AI搜索类和用户触发类。想保护原创内容、又不想从AI回答里消失,选“屏蔽AI训练但允许AI搜索”就够了。常见的反面做法是看到AI抓取的新闻,就给所有AI爬虫写上Disallow: /,结果连AI搜索引用页面时用的爬虫也挡在门外。想让AI更准确地理解站点结构,可以再生成一份llms.txt文件作补充。
用户触发类要单独理解。ChatGPT-User、Perplexity-User、Meta-ExternalFetcher和Amzn-User是在有人提问时替这个人去打开页面,robots.txt对它们只是一个请求,它们可能不予理会。真要挡住,只能靠登录或服务器层面的拦截。
爬虫名单共39个,AI部分逐一对照各厂商自己的文档:OpenAI、Anthropic、Perplexity、Google、Apple、Meta、Amazon和Common Crawl,最近一次核对在2026年10月10日。字节跳动的Bytespider也在名单里,但运营方没有公开说明文档,名单里如实标注为未公开。设置完成后,想知道站点在AI搜索里能见度如何,可以做一次站点GEO审计。
通配符*和$的写法对照
通配符写错是robots.txt里最隐蔽的问题,文件看着整齐,匹配范围却和你想的不一样。生成器内置了下面这几种现成写法:
| 你想要的效果 | 生成器写出的规则 | 匹配范围 |
|---|---|---|
| 整个文件夹 | /private/ | 该文件夹及其中所有内容 |
| 某种文件类型,不论位置 | /*.pdf$ | 所有以“.pdf”结尾的地址 |
| 带某个参数的地址 | /*?sort=和/*&sort= | 参数排在第一位或后面都能匹配 |
| 所有带查询字符串的地址 | /*? | 任何含有问号的地址 |
| 只限一个地址 | /thank-you$ | 只匹配这一页,不含/thank-you/more这类子页 |
| 含某个词的地址 | /*preview | “preview”出现在地址任何位置都会命中 |
| 屏蔽文件夹但留一个文件 | 先Disallow文件夹,再Allow这个文件 | 文件夹挡住,这个文件照常开放 |
判定规则很固定:*代表任意一段字符,$表示地址到此结束。两条规则同时命中时,路径更长的那条生效;长度相同,Allow优先。路径区分大小写,/Private/和/private/是两条不同的规则。这套判定依据Google搜索中心的robots.txt文档和RFC 9309,其中还包括两条细节:Google的次级爬虫找不到自己的组时,会改用Googlebot的组;AdsBot则不理会面向所有爬虫的通用组。
具名爬虫的组最容易出错。爬虫只服从最贴近自己名字的那一组,通用组里的规则对它不再生效。比如通用组里屏蔽了/admin/,又单独给Baiduspider写了一组放行规则,百度蜘蛛就会照样去抓后台目录。ToolsPivot会把通用规则自动复制进每个具名爬虫的组,堵上这个漏洞。
生成器会拦下哪些错误
检查清单随文件实时刷新,覆盖下面这些情况:
- 整站屏蔽:User-agent: *下面跟着Disallow: /。
- 屏蔽了搜索引擎:给Googlebot这类搜索爬虫写了全站禁止。
- 挡住了CSS或JavaScript,搜索引擎渲染页面时拿不到这些文件。
- 路径缺少开头的斜杠,写成了private/。
- 站点地图写成相对地址。
- $出现在规则中间,而它只能放在末尾。
- 用了正则表达式语法,比如把*写成“.*”。
- 写了不受支持的指令:Noindex、Host、Clean-param。
- 某个爬虫的专属组覆盖了通用规则。
- 文件超过500 KiB的大小上限。
其中代价最大的两个错误会单独提醒。第一个是上线后遗留的整站屏蔽,新站从测试环境迁过来,最常见的“搜不到网站”就出在这一行。第二个是把Disallow当成从Google删除页面的办法。Google的文档写得很清楚,遭到屏蔽的网址如果在别处有链接,仍可能编入索引,只是不显示摘要,Search Console里会提示网页“已编入索引,尽管遭到robots.txt屏蔽”。
想让页面退出搜索结果,正确做法是放开抓取,再给页面加上noindex,然后用网页Meta标签检查工具确认标签已经生效,过一段时间再用收录查询工具看页面是否掉出索引。如果检查清单提示CSS或JavaScript遭到屏蔽,改完之后可以跑一遍移动设备适配测试,看页面能否正常渲染。
检查线上文件会看到什么
在“检查线上文件”输入域名后,ToolsPivot的服务器会去请求该域名下的/robots.txt,报告状态码、每一次重定向、内容类型和文件大小。它最多跟随5次重定向,最多读取600 KB,30秒没有结果就停止,每位访客每天可以查询40次。
结果这样看:状态码应为200。按Google的规则,429以外的4xx状态码会被当作网站没有robots.txt,等于不设限制;5xx状态码则会让Google暂停抓取全站,这比文件写错更危险,可以用服务器状态检查多测几次。重定向会逐跳列出,跳转链过长时,用重定向检查工具排查www与非www的设置。内容类型通常应是text/plain,如果返回的是网页类型,往往说明服务器拿首页或错误页顶替了robots.txt,HTTP头信息查询能看到完整的响应头。
读取上限定在600 KB,比500 KiB的检查上限多出一截,所以超限的文件也能完整读回并标出问题。取回的文件可以“载入生成器”继续编辑,检查清单和测试地址照常可用。
导出的robots.txt是UTF-8编码、不带BOM,组与组之间空一行。文件必须放在网站根目录,也就是“域名/robots.txt”这个位置。“文件放在哪里”分别说明了WordPress、Shopify、Wix和Squarespace的放法。上传后,用蜘蛛模拟器看一眼爬虫实际能读到的页面内容,确认没有误伤。
这个工具做不到什么
说到底,robots.txt是请求,不是强制。守规矩的搜索引擎会照做,用户触发的抓取器可能不理会,恶意爬虫更不会遵守。私密内容请用登录保护,单靠robots.txt挡不住。
测试地址按Google公布的匹配规则判定,百度、必应等其他爬虫的处理方式可能不同。网站主要做百度流量的话,测试结果只能作参考,最终以百度搜索资源平台的说明和实际抓取记录为准。在Shopify格式下,测试只覆盖你追加的规则,不包括Shopify内置的那部分。线上检查每天限40次,只接受域名,只读取根目录下的/robots.txt。
和老牌中文生成器比,差别主要在名单和检查上。站长工具(tool.chinaz.com/robots)的生成器名单里还列着SOSO、有道、Cuil、MSN Search、DMOZ和Alexa/Wayback这些早已停止运营的搜索引擎或目录,没有AI爬虫,也不提供检查、测试或载入现有文件。如果你只需要一份全站允许的最简文件,它也够用。miniwebtool的中文版同样可以粘贴现有文件做验证。要看Google实际读到的是哪个版本,最权威的仍是Search Console里的robots.txt报告。上线前想把标题、速度、链接等问题一次看全,可以再跑一遍网站SEO检测。
数据来自工具方法说明:爬虫名单核对于2026年10月10日,匹配规则以Google搜索中心文档和RFC 9309为准;竞品信息查看于2026年11月15日,上线后待复测。
常见问题
放在网站根目录,访问“域名/robots.txt”就能打开。放进子目录的文件爬虫不会读取,子域名也需要各自放一份。
Disallow只禁止抓取,不禁止收录。别的网站链接到这个地址时,搜索引擎仍可能把它编入索引,只显示网址不显示摘要。要彻底移出,得放开抓取并加noindex。
不会。第二步的AI选项只作用于18个AI爬虫,Googlebot和Baiduspider走的是各自的规则组。只要没有在通用组里写全站禁止,搜索收录不受影响。
可以。没有这个文件,搜索引擎会默认整站都能抓取,效果和“全部允许”模板一样。需要屏蔽后台、搜索结果页或参数页时,再生成一份也不迟。
Google通常会把robots.txt缓存最多24小时,所以改动一般在一天内生效。其他搜索引擎的刷新周期各不相同。
不够稳妥。测试站模板能告诉守规矩的爬虫别来抓,但网址一旦外泄,页面仍可能收录。更可靠的做法是给测试站加密码,并记得上线时撤掉整站屏蔽。
不会。生成、检查和测试都在你的浏览器里完成,只有“检查线上文件”会让服务器去取目标域名的robots.txt。想下次接着改,复制那个能还原设置的链接保存即可。