عن مولد ملف robots.txt
يبني مولد ملف robots.txt من ToolsPivot ملفًا صالحًا لموقعك من قواعد تختارها من قوائم واضحة بدل كتابتها حرفًا حرفًا، ثم يفحصه بحثًا عن الأخطاء التي تُخرج المواقع من نتائج Google، ويختبر عليه أي عنوان تريد قبل أن ترفعه إلى جذر نطاقك. تعرف الأداة 39 زاحفًا حاليًا، منها 18 زاحف ذكاء اصطناعي مقسّمة حسب الغرض منها، وتنطلق من الملف الافتراضي الذي تنتجه منصتك فعلًا، لا من قالب قديم منسوخ من موقع آخر.
كيفية إنشاء ملف robots.txt باستخدام ToolsPivot
تمر الأداة بخمس خطوات متتالية، ويتحدّث الملف الناتج أمامك مع كل تغيير، فلا تحتاج إلى زر إنشاء في النهاية:
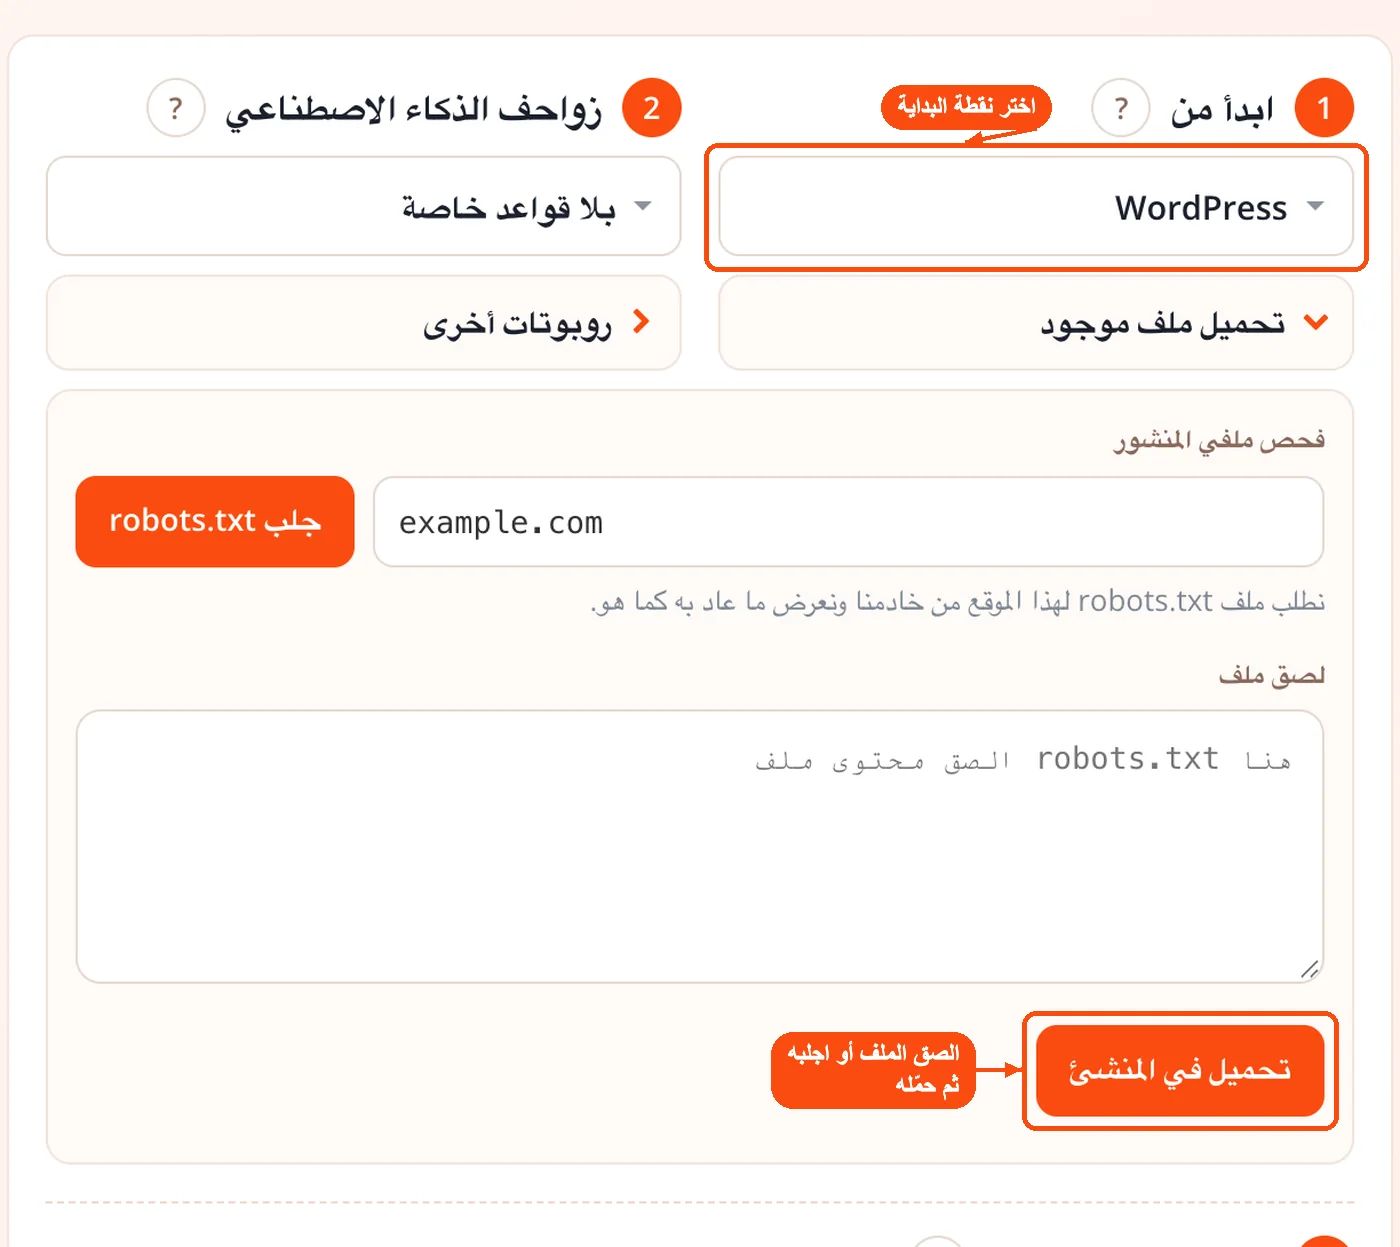
- اختر نقطة البداية: السماح بكل شيء، أو الملف الافتراضي لمنصة WordPress أو WooCommerce أو Joomla أو Drupal أو Magento أو Shopify، أو إعداد «موقع تجريبي»، أو حظر كل شيء. وإن كان لموقعك ملف قائم فالصقه في الأداة، أو اكتب اسم النطاق لتجلبه مباشرة من الموقع.
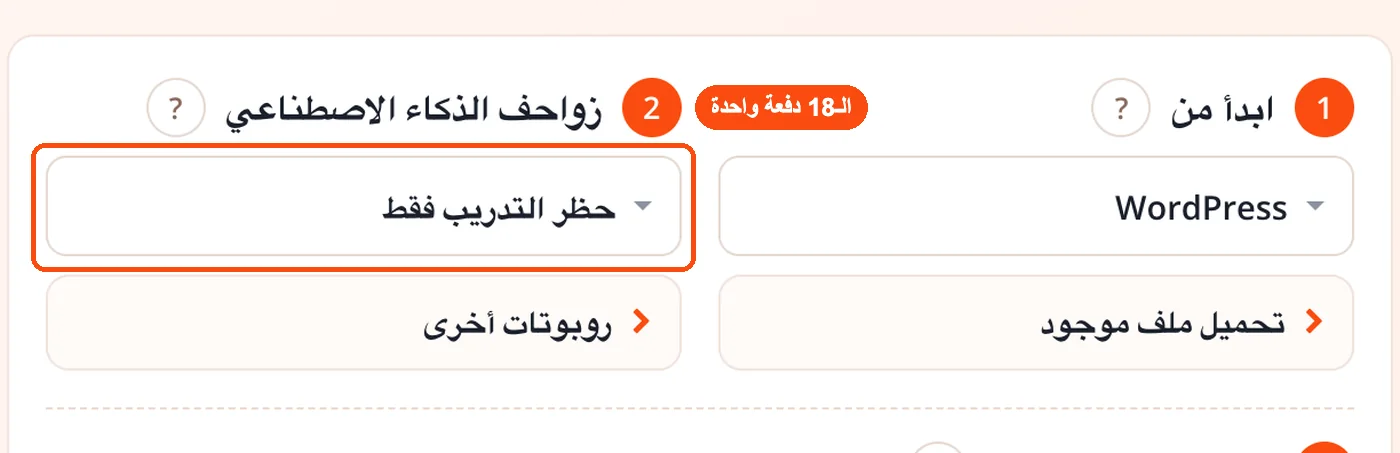
- حدّد سياسة زواحف الذكاء الاصطناعي بخيار واحد من أربعة: بلا قواعد خاصة، أو حظر التدريب مع السماح بالبحث، أو حظرها كلها، أو ضبط كل زاحف على حدة.
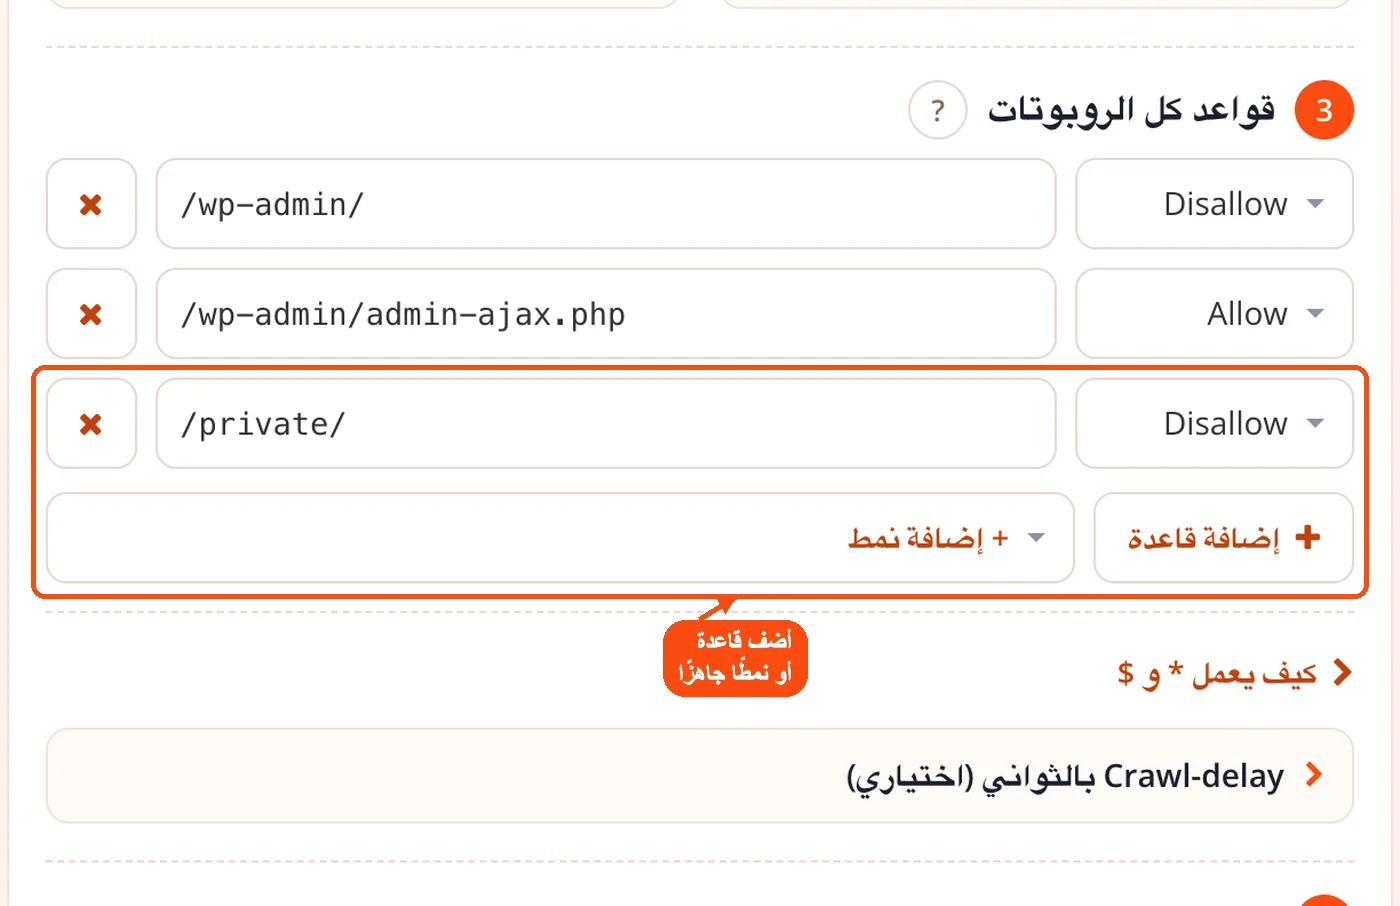
- أضف صفوف السماح والمنع لجميع الروبوتات، أو اختر نمطًا جاهزًا مثل «نوع ملف، في أي مكان» لتكتب الأداة صيغة النجمة وعلامة الدولار نيابةً عنك. ويمكنك أيضًا تخصيص قواعد لروبوت بعينه.
- أضف عنوان خريطة الموقع، أو أكثر من عنوان. يكفي أن تكتب المسار
/sitemap.xmlلتكمله الأداة إلى عنوان كامل يبدأ بنطاقك، وإن لم تكن لديك خريطة بعد فأنشئها أولًا عبر مولد خريطة الموقع.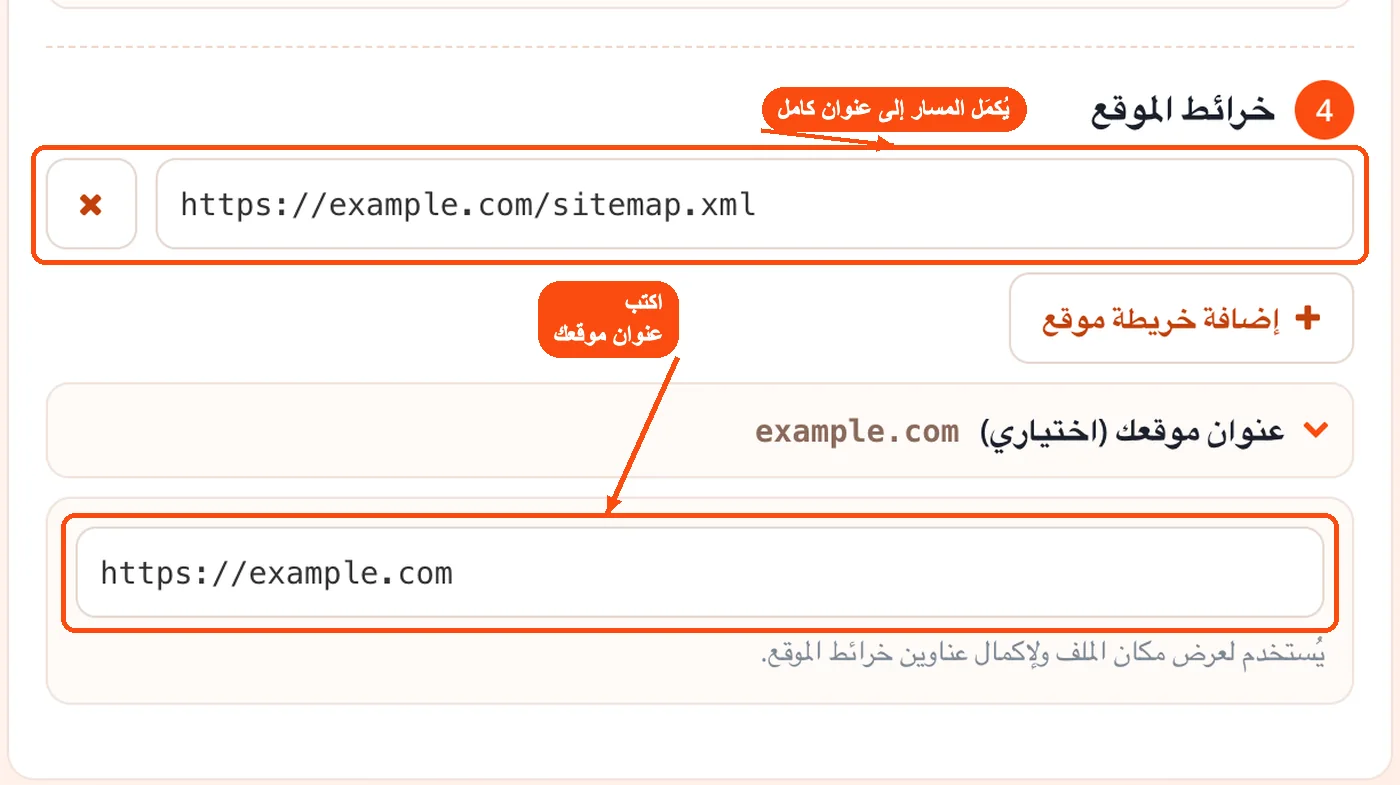
- راجع قائمة الفحوص والملخص المكتوب بلغة مفهومة، وجرّب عناوينك في المختبر، ثم انسخ الملف أو نزّله، أو انسخ رابطًا يعيد هذا الإعداد كما هو حين تعود إليه.
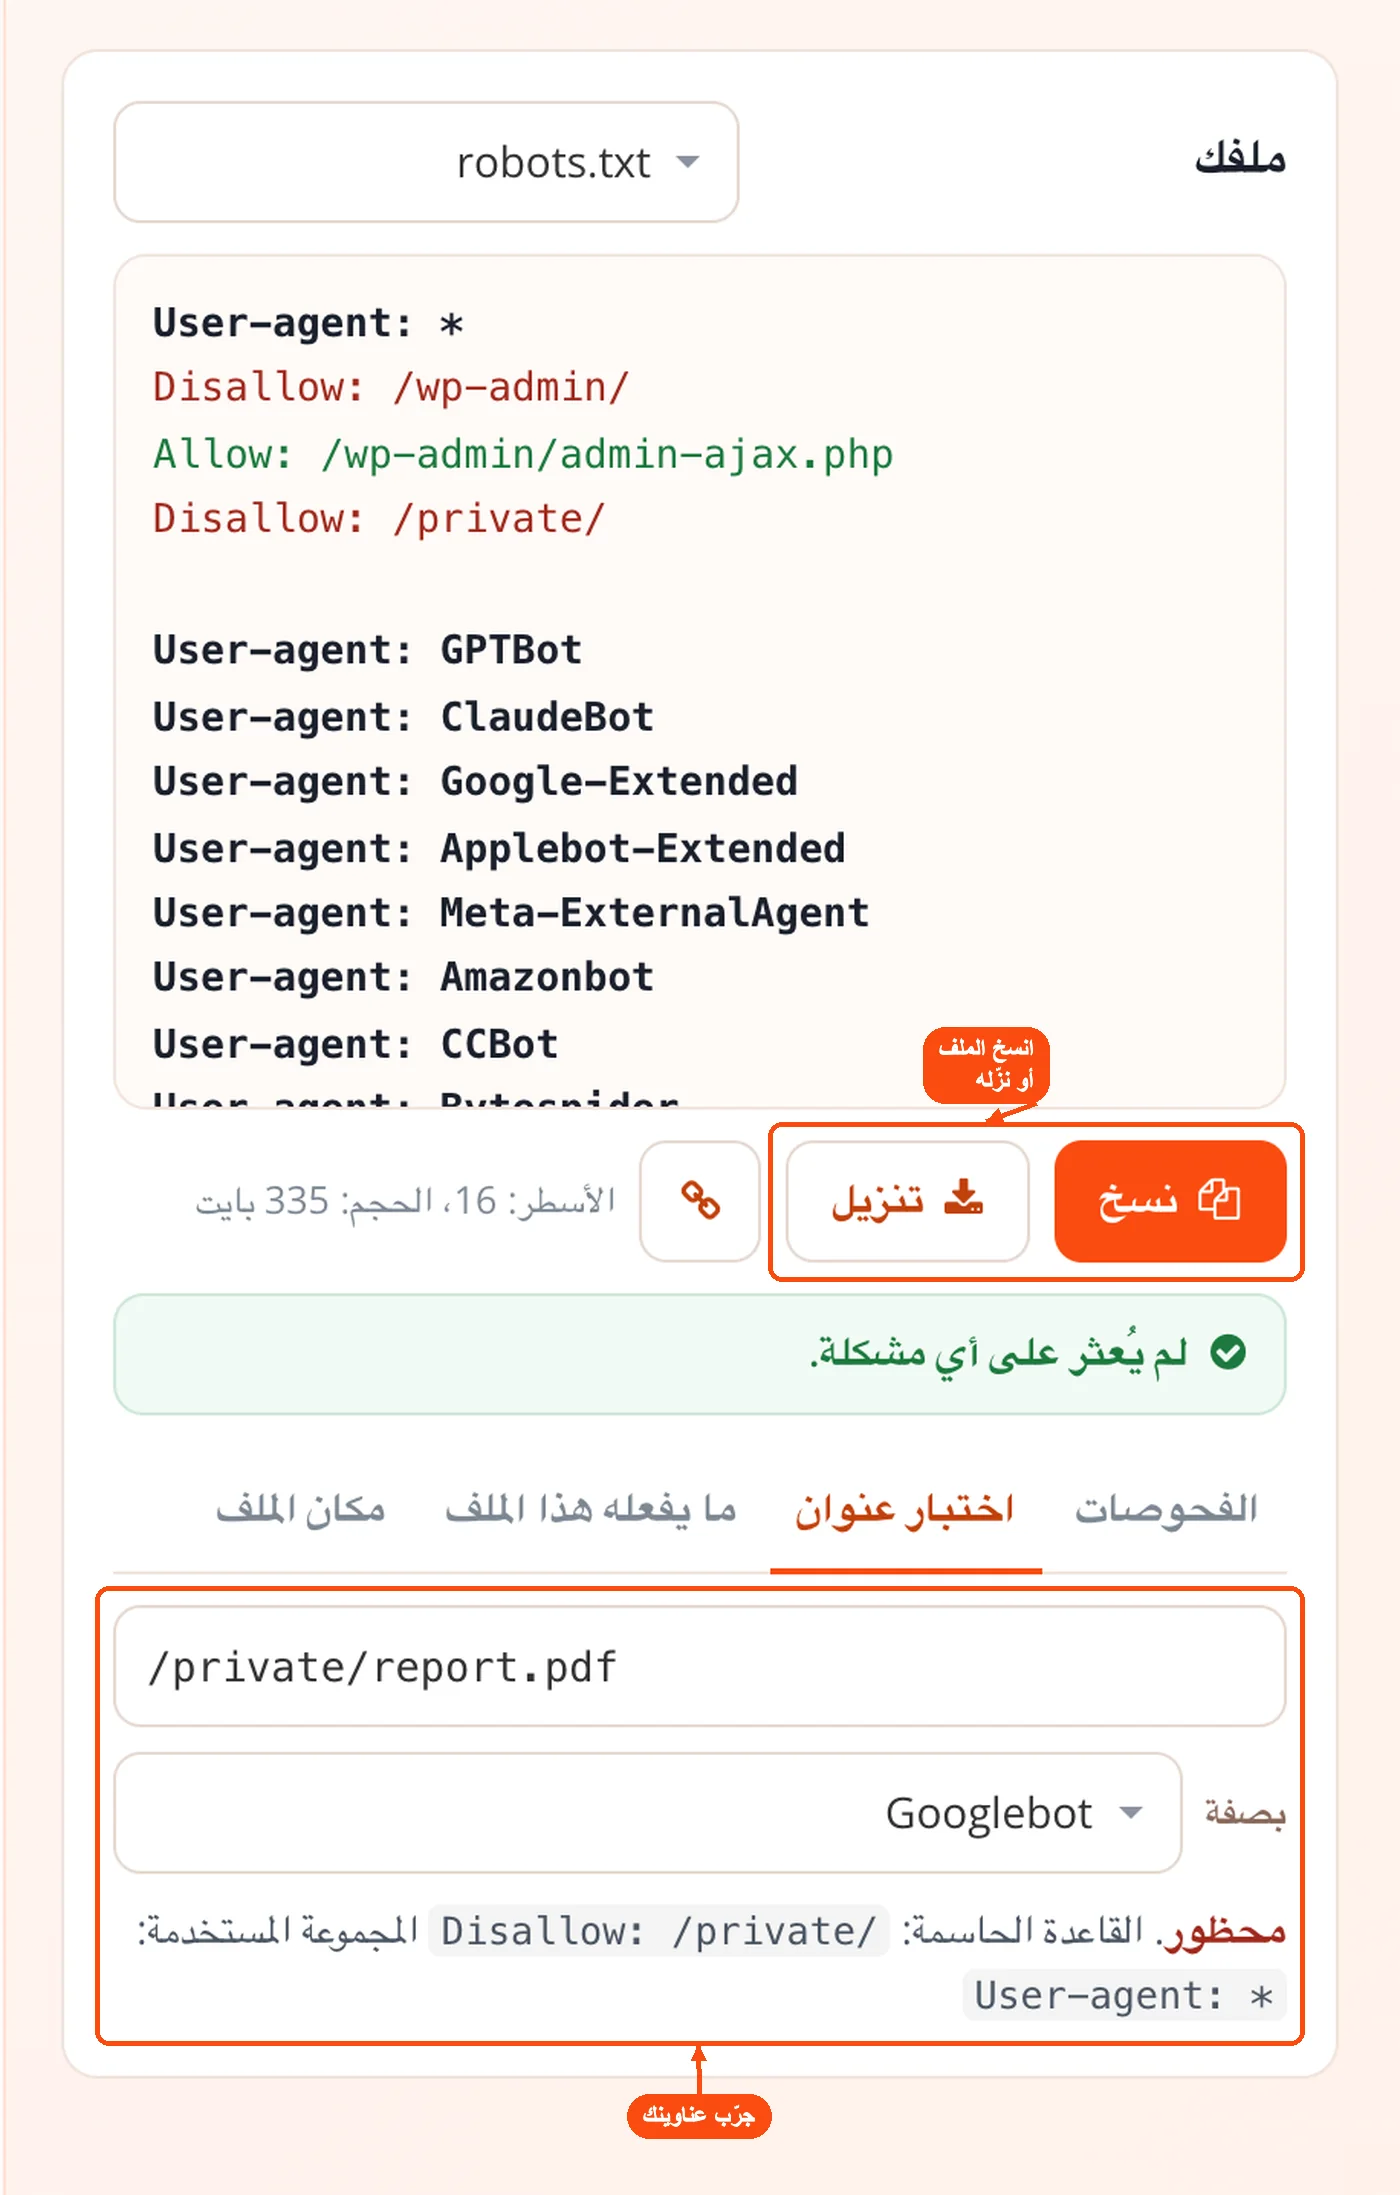
تجري القراءة والكتابة والفحص والمطابقة كلها داخل متصفحك، فلا يرسل ToolsPivot القواعد التي تكتبها إلى أي خادم. الاستثناء الوحيد هو الجلب المباشر في الخطوة الأولى: يقبل الخادم اسم نطاق فقط، ويطلب منه المسار /robots.txt دون غيره، ويرفض العناوين الداخلية للشبكات المحلية.
حظر تدريب الذكاء الاصطناعي دون الاختفاء من إجاباته
يضع كثير من أصحاب المواقع كل زاحف يحمل اسم شركة ذكاء اصطناعي في سلة واحدة ويمنعه، فيخسرون الاستشهاد بمحتواهم في إجابات محركات الذكاء الاصطناعي وهم يظنون أنهم منعوا التدريب فقط. والواقع أن معظم هذه الشركات تشغّل أكثر من زاحف، لكل منها وظيفة مختلفة، لذلك تقسم الأداة الزواحف الثمانية عشر إلى ثلاث مجموعات:
| المجموعة | أمثلة من القائمة | ما يعنيه حظرها |
|---|---|---|
| زواحف التدريب | GPTBot، ClaudeBot، CCBot، Meta-ExternalAgent، Google-Extended، Applebot-Extended | تطلب استبعاد صفحاتك من بيانات تدريب النماذج القادمة، ويبقى ظهورك في محركات البحث كما هو. |
| زواحف البحث بالذكاء الاصطناعي | OAI-SearchBot، Claude-SearchBot، PerplexityBot | تخرج صفحاتك من المصادر التي تعرضها هذه الخدمات وتستشهد بها في إجاباتها. |
| الجلب بطلب من شخص | ChatGPT-User، Perplexity-User، Meta-ExternalFetcher، Amzn-User | قد لا يلتزم الجالب بالحظر، لأن الزيارة تحدث حين يطلب مستخدم صفحة بعينها. |
خيار «حظر التدريب فقط» يكتب مجموعات منع لزواحف التدريب وحدها، فتمنع مثلًا GPTBot وتترك OAI-SearchBot يصل إلى صفحاتك. وتذكر OpenAI أن أنظمتها قد تحتاج إلى نحو 24 ساعة حتى تلتقط تعديل الملف، فلا تحكم على النتيجة في اليوم نفسه. أما Bytespider فتعرضه الأداة مع تنبيه بأن الجهة المشغّلة له لم تنشر وثائق رسمية عنه، فلا ضمان لالتزامه بأي قاعدة.
وقبل أن تلوم الملف على غياب موقعك عن إجابات الذكاء الاصطناعي، تأكد أن جدار الحماية أو شبكة توزيع المحتوى لا يردّان على هذه الزواحف بالرمز 403، لأن قاعدة السماح في الملف لا تنفع إذا رفض الخادم الطلب نفسه. يكشف لك فاحص حالة الخادم الرمز الذي يعيده موقعك، وبعدها راجع جاهزية صفحاتك للاستشهاد بها عبر تدقيق الظهور في محركات الذكاء الاصطناعي.
أنماط النجمة وعلامة الدولار وما تطابقه فعلًا
تعني النجمة * أي سلسلة من الأحرف بأي طول، حتى الصفر، وتعني علامة الدولار $ نهاية العنوان. وإذا انطبقت قاعدتان على العنوان نفسه فالأطول هي التي تُطبَّق، وعند تساوي الطول تفوز قاعدة السماح. أما المسارات فحساسة لحالة الأحرف، فالقاعدة التي تمنع /private/ لا تمنع /Private/. هذه وصفات الأداة الجاهزة وما تكتبه كل منها:
| الوصفة | ما تكتبه الأداة | ما تطابقه |
|---|---|---|
| مجلد كامل بما فيه | /private/ | المجلد وكل ما بداخله |
| نوع ملف في أي مكان | /*.pdf$ | كل عنوان ينتهي بالامتداد pdf |
| عناوين تحمل معاملًا معينًا | /*?sort= و/*&sort= | المعامل في الموضع الأول أو في أي موضع بعده |
| كل عنوان فيه سلسلة استعلام | /*? | أي عنوان يحتوي على علامة الاستفهام |
| عنوان واحد بعينه | /thank-you$ | الصفحة نفسها فقط، لا /thank-you/more |
| عناوين تحتوي على كلمة | /*preview | أي عنوان ترد فيه الكلمة |
| مجلد ممنوع باستثناء ملف | منع المجلد والسماح بالملف | يبقى المجلد مغلقًا ويظل الملف متاحًا |
جرّب هذا الملف في مختبر العناوين لترى قاعدة الطول وحساسية الأحرف معًا:
User-agent: *
Disallow: /private/
Allow: /private/price-list.pdf
العنوان /private/price-list.pdf مسموح، لأن قاعدة السماح تتكون من 23 حرفًا وقاعدة المنع من 9 أحرف فقط. والعنوان /private/notes.html ممنوع، إذ لا تنطبق عليه إلا قاعدة المنع. أما /Private/notes.html بحرف P كبير فمسموح، فلا قاعدة منهما تطابقه، وهذا خطأ يتكرر في المواقع التي يختلف فيها شكل الروابط بين القوائم والصفحات.
ولا يدعم Google التعبيرات النمطية، فصيغ مثل ^/blog أو [0-9] لا تعمل كما يتوقع من كتبها. تنبهك الأداة إلى هذه الصيغ، وإلى وضع $ في وسط النمط، لأن العلامة لا معنى لها إلا في آخره.
قراءة الفحوص ونتيجة الجلب المباشر
تعمل قائمة الفحوص وأنت تبني الملف، وأخطر ما تنبهك إليه ثلاثة أمور:
- منع شامل للموقع: السطر
Disallow: /تحتUser-agent: *، وهو غالبًا بقايا موقع تجريبي نُقل إلى النطاق الحقيقي كما هو. - منع محرك بحث بالاسم، كأن تُكتب مجموعة للزاحف Googlebot أو Bingbot تمنع الموقع كله.
- منع ملفات CSS أو JavaScript التي يحتاجها Google لعرض الصفحة كما يراها الزائر.
وتشمل بقية الفحوص غياب الشرطة المائلة في أول المسار، وعنوان خريطة موقع نسبيًا بدل عنوان كامل، والتعليمات التي لا يدعمها Google مثل Noindex وHost وClean-param، وتجاوز الملف حد 500 KiB الذي يتجاهل Google كل ما بعده.
ويستحق فحص واحد شرحًا أطول، وهو مجموعة الروبوت المسمّى التي تلغي القواعد العامة. يقرأ Google مجموعة واحدة فقط لكل زاحف، هي الأكثر تحديدًا لاسمه، ولا يدمجها مع مجموعة النجمة. فإذا منعت /cart/ للجميع ثم كتبت مجموعة خاصة بالزاحف Googlebot تسمح بمجلد واحد، فسيزحف Googlebot إلى السلة أيضًا. كان الإصدار السابق من مولد ToolsPivot يقع في هذا الخطأ نفسه، أما الإصدار الحالي فينسخ القواعد العامة إلى كل مجموعة مسمّاة تلقائيًا.
وفي الجلب المباشر تعرض الأداة رمز الحالة وكل تحويل ونوع المحتوى والحجم، ولكل منها دلالة عند Google:
- رمز من فئة 2xx: يُقرأ الملف كما هو.
- رمز من فئة 4xx عدا 429: يعامله Google كأن الملف غير موجود، أي بلا أي قيود، لذلك لا يصلح الرمز 403 لمنع الزحف.
- رمز من فئة 5xx: يتوقف Google عن الزحف إلى الموقع كله في أول 12 ساعة، ثم يعتمد آخر نسخة سليمة خزّنها لمدة تصل إلى 30 يومًا.
- التحويلات: يتتبع Google خمس قفزات على الأقل ثم يعامل الملف كأنه غير موجود، وتتتبع الأداة حتى 5 تحويلات، ويمكنك فحص السلسلة كاملة عبر فاحص تحويل www.
تقرأ الأداة حتى 600 KB من الملف، أي أكثر من الحد الذي يقرؤه Google، كي تنبهك إن تجاوزه ملفك. وبعد رفع الملف، اعرض صفحاتك كما يراها الزاحف عبر محاكي عناكب البحث.
أخطاء تُخرج المواقع من نتائج البحث وطريقة إصلاحها
منع شامل نسيه أحد بعد الإطلاق. ينتقل الموقع من بيئة التجربة إلى النطاق الحقيقي ومعه السطر Disallow: /، فتبدأ الصفحات بالخروج من النتائج. احذف السطر، ثم افتح تقرير ملفات robots.txt في Search Console واطلب إعادة الزحف، لأن Google يحتفظ بنسخة مخزّنة من الملف لمدة تصل إلى 24 ساعة.
استخدام المنع لحذف صفحة من Google. إذا منعت الزحف إلى صفحة تشير إليها روابط من مواقع أخرى، فقد تبقى في النتائج بلا وصف، وتظهر في تقرير الصفحات تحت حالة «تمت فهرستها على الرغم من حظرها بواسطة ملف robots.txt». والسبب أن Google لا يرى علامة noindex في صفحة لا يُسمح له بزحفها. الحل أن ترفع المنع وتضيف العلامة، ثم تتأكد من وجودها عبر فاحص الوسوم الوصفية، أو من ترويسة X-Robots-Tag عبر عارض ترويسات HTTP، ثم تابع حالة الصفحة في فاحص الفهرسة حتى تخرج من النتائج.
قالب WordPress قديم يمنع مجلد wp-includes. ما زال قالب WordPress في أداة منافسة اختبرناها يمنع /wp-includes/ ومجلدات القوالب والإضافات، وعند إدخال العنوان /wp-includes/js/jquery/jquery.min.js في مختبر الأداة يظهر أنه ممنوع على Google، أي أن مكتبة jQuery التي يعتمد عليها كثير من القوالب لا تصل إلى الزاحف. يبدأ قالب WordPress في أداتنا من الملف الذي ينتجه WordPress نفسه، وهو لا يمنع إلا /wp-admin/ مع السماح بالملف admin-ajax.php. وبعد التصحيح تأكد من أن الصفحة تُعرض كاملة عبر اختبار التوافق مع الجوال.
أين تضع الملف في WordPress وShopify وBlogger
يجب أن يكون الملف في جذر المضيف باسم robots.txt بأحرف صغيرة، مثل https://example.com/robots.txt، ولا يقرأ أي زاحف ملفًا موضوعًا في مجلد فرعي. ويحتاج كل نطاق فرعي وكل بروتوكول إلى ملف مستقل، فملف example.com لا يسري على shop.example.com ولا على نسخة http من الموقع.
في WordPress: ينشئ WordPress ملفًا افتراضيًا لا وجود له على القرص، ويتوقف عن عرضه إذا رفعت ملفًا حقيقيًا باسم robots.txt إلى المجلد الجذري للموقع. ويتيح لك Yoast SEO تعديل الملف من محرر الملفات في قائمة الأدوات، ويتيح Rank Math ذلك من إعداداته العامة.
في Shopify: لا تستطيع رفع ملف مباشرة، فالمنصة تولّد الملف من قالب robots.txt.liquid داخل السمة. تكتب الأداة هذا القالب بحيث يحتفظ بقواعد Shopify الافتراضية ويضيف قواعدك إليها، ثم تضيفه أنت من محرر الشيفرة في السمة كقالب جديد من نوع robots.
في Blogger: فعّل خيار ملف robots.txt المخصص من قسم الزواحف والفهرسة في الإعدادات، ثم الصق الملف. لا يتضمن الإصدار الحالي نقطة بداية خاصة بمنصة Blogger، لذا ابدأ من «السماح بكل شيء» وأضف المنع الذي يستخدمه Blogger افتراضيًا لصفحات البحث والتصنيفات، وهو Disallow: /search. أما منصتا Wix وSquarespace فيشرح ToolsPivot مكان الإعداد في كل منهما ضمن ملاحظة تظهر أسفل الملف الناتج.
حدود الأداة ومتى تحتاج إلى أداة أخرى
ملف robots.txt طلب وليس قفلًا. تلتزم به الزواحف المعروفة، أما الجالبات التي تعمل بطلب من شخص مثل ChatGPT-User وPerplexity-User وMeta-ExternalFetcher وAmzn-User فقد تتجاهله، والزواحف الخبيثة لا تقرؤه أصلًا، بل قد تتخذ المسارات الممنوعة دليلًا على ما تريد إخفاءه.
يتبع مختبر العناوين في ToolsPivot قواعد المطابقة التي نشرها Google ومعيار RFC 9309، وقد يختلف غيره من الزواحف في التفاصيل، فمحرك Bing مثلًا يحترم تعليمة Crawl-delay التي يتجاهلها Google تمامًا. وفي صيغة Shopify يغطي المختبر القواعد التي أضفتها أنت، لا القواعد المدمجة في المنصة. أما الجلب المباشر فمحدود بعدد 40 عملية يوميًا لكل زائر، وبقراءة 600 KB كحد أقصى خلال 30 ثانية.
وللمقارنة بإنصاف: تقرير ملفات robots.txt في Search Console هو المرجع الأدق لما جلبه Google فعلًا ومتى، ويعرض ملفات أهم 20 مضيفًا في النطاق ويتيح طلب إعادة الزحف، لكنه يعمل على المواقع التي أثبتّ ملكيتها فقط، ولا يختبر عناوين بعينها منذ أن أوقف Google أداة اختبار robots.txt في نوفمبر 2023. وما زالت بعض صفحات المولدات العربية توجّه القارئ إلى تلك الأداة المتوقفة، وبعضها يعرض زواحف خدمات انتهت منذ سنوات مثل DMOZ وAlexa. ويحتفظ Bing Webmaster Tools بأداة اختبار خاصة بزاحفه، فاستخدمها إن كان محرك Bing يهمك. ولمراجعة الموقع كله بعد ضبط الملف، شغّل فاحص SEO للموقع.
بيانات المنهجية: الأرقام في هذه الصفحة مأخوذة من منهجية الأداة للإصدار 2.0، وقائمة زواحف الذكاء الاصطناعي روجعت على وثائق الشركات المشغّلة في 10 أكتوبر 2026، وتنتظر الأرقام إعادة اختبار بعد الإطلاق.
الأسئلة الشائعة عن ملف robots.txt
يزحف Google إلى الموقع كله دون قيود، لأنه يعامل الرمز 404 كإذن كامل. لا ضرر في ذلك لموقع صغير، لكنك تفقد فرصة الإشارة إلى خريطة الموقع ومنع صفحات الفرز والبحث الداخلي التي تستهلك الزحف بلا فائدة.
يحتفظ Google عادةً بنسخة مخزّنة من الملف لمدة تصل إلى 24 ساعة، وقد تطول المدة إذا تعذّر عليه جلب النسخة الجديدة. وإن كان التعديل عاجلًا، كإزالة منع شامل، فاطلب إعادة الزحف من تقرير ملفات robots.txt في Search Console.
الصيغتان متكافئتان عند الزواحف الملتزمة بمعيار RFC 9309، لأنه يُلزمها بتحويل الأحرف غير اللاتينية إلى ترميز النسبة المئوية قبل المقارنة. ولكي ترى الصيغة المرمّزة لأي مسار وتطابقها مع ما يظهر في سجلات الخادم، استخدم أداة ترميز الروابط وفك ترميزها.
لا، فالملف عام يستطيع أي شخص قراءته بإضافة /robots.txt إلى النطاق، وذكر مسار حساس فيه يدل عليه بدل أن يخفيه. احمِ هذه المسارات بكلمة مرور أو بقيود على الخادم، واترك الملف لتنظيم الزحف وحده.
نعم، لأن سطر Sitemap يقرؤه كل زاحف يزور الملف، لا Google وحده. يمكنك ذكر أكثر من خريطة في الملف نفسه بشرط أن يكون كل عنوان كاملًا يبدأ بالبروتوكول، وهذا ما تفعله الأداة حين تكمل المسار النسبي.
لا، فهو رمز تحكم وليس زاحفًا مستقلًا، ويحدد به Google استخدام محتواك في تدريب نماذج Gemini وتأسيس إجاباتها، دون أن يمس ظهورك أو ترتيبك في البحث. أما الزحف لنتائج البحث نفسها فيتولاه Googlebot.
يحدد ملف robots.txt المسارات التي يُسمح للزواحف بطلبها، بينما يقدّم ملف llms.txt لأنظمة الذكاء الاصطناعي دليلًا مختصرًا إلى أهم صفحاتك، وهو اقتراح لم يُعتمد معيارًا رسميًا حتى الآن. يمكنك إنشاء الثاني عبر مولد ملف llms.txt، ولا يغني أحدهما عن الآخر.
لا يرفع الملف الترتيب مباشرة، لكنه قد يضرّ به إذا منع صفحات أو موارد يحتاجها Google. وتظهر فائدته الحقيقية في المواقع الكبيرة والمتاجر، حين يبعد الزحف عن آلاف العناوين المكررة التي تولّدها معاملات الفرز والتصفية.